口搓 02|干两小时,歇三小时:被 AI 安排的番茄钟
做 Uncle Ed 的五天里,我用掉了约千 M Token。额度快见底那天,我问 Codex 的第一句话是:"恢复后能不能接着做?"
那之后我干脆装了个工具,专门盯着用量。
上一篇讲了 Codex 和 Claude 的性格。这一篇算账:同样一份 20 美元的会员,为什么有人说够用一周,有人说一个下午就没了?国产方案便宜,是能力不够,还是更划算?
结论先放这里:AI 会员不是 token 包。真正该比的,是同样的钱能完成多少件合格的活。
一、会员不是 token 包
先说一个很多人没注意的事实:ChatGPT Plus 和 Claude Pro 都没有承诺"每周给你多少 token"。
两家的规则长得很像:
- 按时间窗口限额。 用量按 5 小时一个窗口算,另外可能有周上限。
- 聊天和写代码共用。 Claude 官方写明,Claude 和 Claude Code 共用同一份额度。
- 消耗看任务。 模型、上下文长短、附件、工具调用,都会影响扣多少。
这意味着,你说一句"帮我修一下这个问题",背后可能是改一个函数,也可能是读几十个文件、跑测试、看报错、再改几轮。你只发了一条消息,它已经干了很多轮活。
做过手机的人应该熟悉这个逻辑。这就像流量套餐写的是"不限量",但后面有一行小字:超过多少降速。真正决定体验的,是那行小字。
二、五小时:一个倒过来的番茄钟
先吐个槽。
番茄工作法大家都知道:干 25 分钟,歇 5 分钟,休息是你自己给自己定的。AI 会员的五小时窗口正好倒过来:额度用完,你就得停,什么时候能接着干,它说了算。我做 Uncle Ed 的时候,五小时的窗口常常两小时左右就见底,然后就是干等刷新。
干两小时,歇三小时。这是一个被 AI 安排的番茄钟。
有朋友吐槽得更直接:设计这个机制的人,真狗。
但吐槽归吐槽,这个机制不是拍脑袋来的。
它从哪来? 说白了就是算力不够分。
最早这么干的是 OpenAI。2023 年 GPT-4 刚上线,Plus 用户每几个小时只能发几十条消息,上限还调过好几次。Claude Pro 同年上线时,是按 8 小时一个周期算;2024 年改成了现在大家熟悉的 5 小时滚动窗口。
到了 Agent 时代,这个窗口开始真正卡人。聊天一来一回,一个窗口很难用完;Agent 一个任务就要读几十个文件、跑几轮测试,额度掉得飞快。
厂商的理由,说得也很直白。
- 防"薅"和防"挂机"。 2025 年 7 月,Anthropic 宣布在五小时之外再加一道周上限,理由是有人共享账号、有人让 Claude Code 全天候不停地跑,并说受影响的用户不到 5%。
- 削峰。 OpenAI 的 Codex 负责人今年 8 月解释过:五小时限额是为了"把算力负载抹平",这样周额度才能给得大方一些。今年 3 月,Anthropic 也承认,工作日高峰时段,五小时额度会掉得更快。
- 保护新手。 同样是 OpenAI 的说法:Plus 用户很多是新手,没有五小时这道闸,有人一不小心一天就把一周的额度花光了,然后一脸茫然。
最近几个月,风向在变。
- 7 月,OpenAI 发布新模型后流量暴涨,干脆临时取消了 Codex 的五小时限额,所有付费档位都只剩周上限。有开发者在 GitHub 上提议:别恢复了。
- 8 月底,OpenAI 给 Plus 用户把五小时限额加了回来,200 美元和 100 美元的 Pro 用户"未来几个月"继续不设。
- 就在这周,Anthropic 把 200 美元那一档改名叫 Ultra,通过验证的账户不再有五小时限额。周上限还在,Ultra 是 Pro 的 10 倍;20 美元的 Pro 照旧,五小时和周上限都有。
翻译一下:五小时限额,正在变成一种"穷人税"。付 200 美元的人,可以一口气干到周额度用完;付 20 美元的人,还得按 AI 的番茄钟上下班。
口碑呢?没有一家用户是喜欢它的。Anthropic 加周上限那次,开发者社区骂声一片;OpenAI 取消五小时那几周,用户反馈也很分裂:不用被打断很爽,但有人发现周额度两天就烧完了,后面五天更难熬。
我的看法是:五小时窗口本身不狗,狗的是它不透明。你不知道一个窗口到底值多少活,也不知道高峰时段会扣得更快。这就回到这篇的主题:会员不是 token 包,你得自己记账。
三、把套餐摆在一张桌上
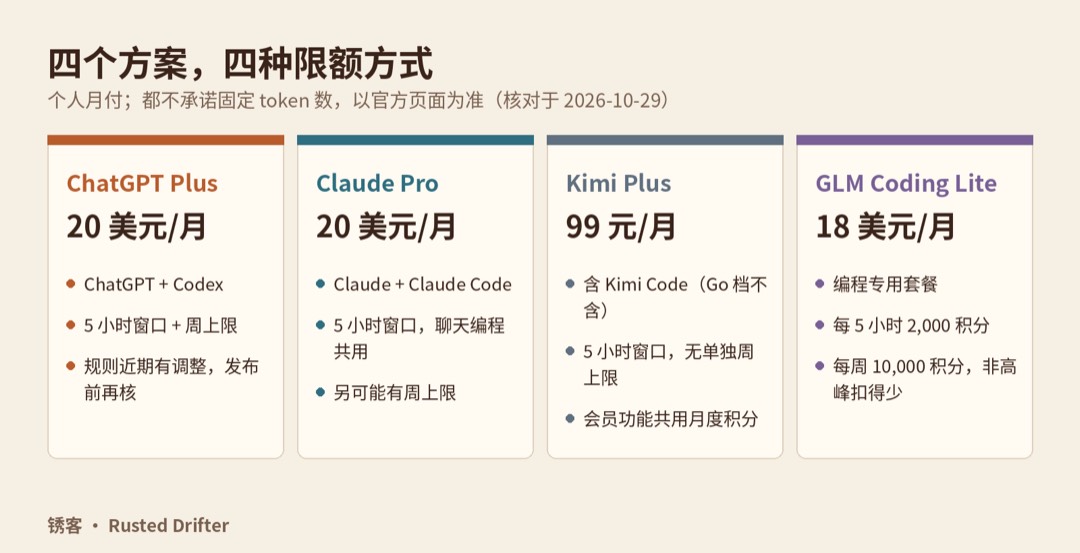
只看个人月付,不算首月优惠:
| 方案 | 价格 | 包含什么 | 额度怎么限 |
|---|---|---|---|
| ChatGPT Plus | 20 美元/月 | ChatGPT + Codex | 5 小时窗口 + 周上限,不公布固定 token 数(5 小时限额 7 月临时取消,8 月 25 日起对 Plus 恢复) |
| Claude Pro | 20 美元/月 | Claude + Claude Code | 5 小时窗口 + 周上限,聊天和编程共用(200 美元的 Ultra 已取消 5 小时窗口,只留周上限) |
| Kimi Plus(中国区新套餐) | 99 元/月 | 含 Kimi Code | 5 小时窗口,无单独周上限;所有会员功能共用每月积分 |
| GLM Coding Plan Lite(国际站) | 18 美元/月 | 编程套餐,可接多种工具 | 每 5 小时 2,000 积分,每周 10,000 积分;非高峰时段扣得少 |
这里有三个坑:
第一,最便宜的档位不一定能写代码。 Kimi 中国区新的 Go 套餐 49 元,不含 Kimi Code,要从 Plus 99 元起。但老用户的旧套餐还保留着 Code。所以"Kimi 49 元就能用 Code"这句话,对新老用户是两个答案。
第二,国产方案的账更好算。 GLM 把积分规则写得很清楚:多少积分一个窗口,一周多少,什么时段打折。Kimi 新套餐也取消了单独的周上限。对一个怕"半夜额度没了"的人来说,透明本身就是价值。
第三,壳和芯要分开看。 GLM 这类方案可以接进 Claude Code 这样的工具里用,但这时候干活的是 GLM 的模型,额度也是 GLM 的。你用的是 Claude Code 的壳,不是 Claude 的芯。
四、为什么你的额度掉得比别人快
今年有一篇研究,专门分析 AI 写代码时 token 是怎么花掉的。研究者让八个模型在同一套编程题上反复跑,结论很有意思:
- 同一道题,不同次运行,token 消耗最多能差 30 倍。
- 大头是"读",不是"写"。 输入 token 才是主要成本,开了缓存也一样。
- 花得多不等于做得好。 准确率在中等花费时就到顶了,花得特别多的那几次,往往是在反复看文件、反复改。
- 人觉得简单,不代表它花得少。 专家对题目难度的判断,和实际消耗只有弱相关。
在那项研究的设置里,Kimi-K2 和 Claude Sonnet 4.5 平均比 GPT-5 多用 150 万以上的 token。但要注意,那是几代之前的模型和另一套 Agent 框架,不能直接推到今天的 Codex 和 Claude Code 上。
它真正告诉我们的是:额度黑洞往往不是任务太难,而是 AI 在原地打转。
这和我在 Uncle Ed 里的体感一致。最费额度的从来不是做新功能,而是修一个反复回归的问题。
几个省额度的办法,OpenAI 的官方说明里也提到了:
- 任务拆小。 一次只让它做一件能验收的事。
- 上下文瘦身。 AGENTS.md 这类说明文件别写成百科全书,用不到的 MCP 工具先关掉。
- 简单活用小模型。 改文案、调样式,不需要最强的模型。
五、能力:上限高的,往往也贵
光算额度不够,还得看干不干得好。
Revelo 有一个编程榜单,把三套偏真实工作的测试(SWE-Lancer 和两版 Terminal Bench)合在一起,共 60 道题,每道题跑三次。下面是部分结果:
| 模型 | 综合通过率 | 60 题 × 3 次的总 API 成本 |
|---|---|---|
| Claude Opus 5 | 48.3% | 约 1,300 美元 |
| GPT-6 Astra | 45.0% | 约 898 美元 |
| GPT-5.6 Sol | 39.4% | 约 350 美元 |
| DeepSeek V4.1 Flash | 38.9% | 约 87 美元 |
| Kimi K3 | 36.1% | 约 224 美元 |
| GLM-5.2 | 27.2% | 约 376 美元 |
| MiniMax M3 | 15.0% | 约 144 美元 |
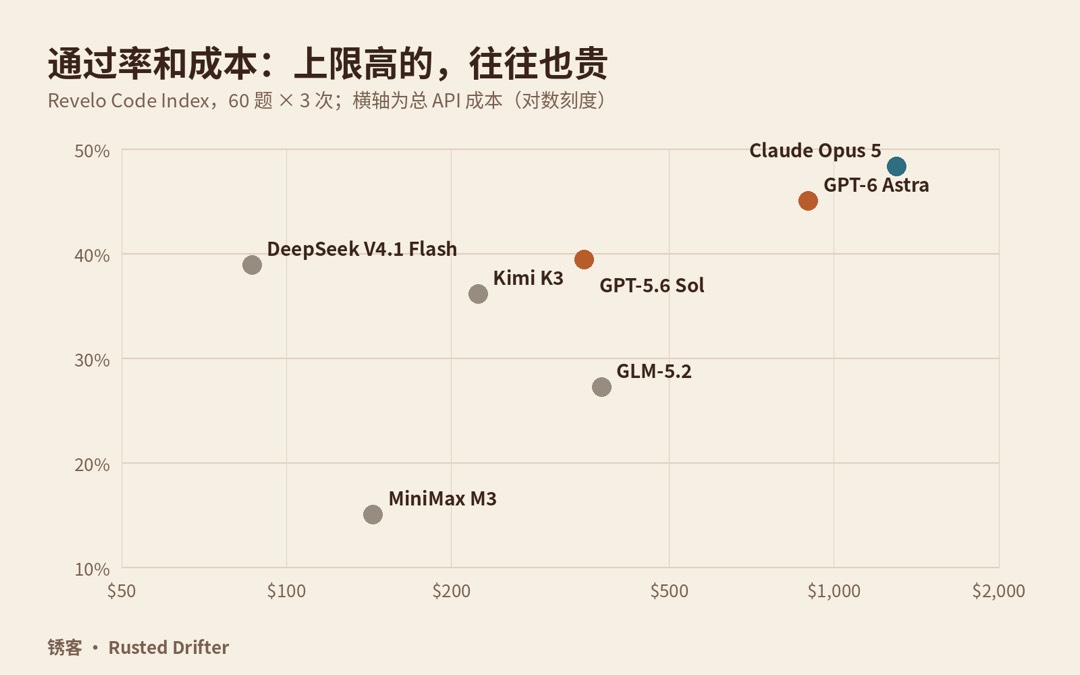
这张表不支持"谁全面碾压谁"。我读出来三点:
- 最强的那个最贵。 Claude Opus 5 通过率最高,花费也最高。
- 便宜不一定差。 DeepSeek 的 Flash 模型用不到十分之一的钱,通过率只差 10 个百分点。
- 便宜也不一定划算。 有的模型 API 单价不高,但通过率低,返工的钱和时间都要算进去。
还有两点要说清楚。第一,60 道题代表不了所有语言和项目,更测不了中文需求理解和前端审美。第二,榜单上的模型不等于你会员里能用的模型,推理档位和 Agent 环境也未必一样。不能拿旗舰模型的成绩,给入门套餐背书。
另一个常被引用的榜单 SWE-bench Verified,头部模型已经都在 96% 以上,Vals 已经把它从综合排名里移出去了。拿它比谁更强,意义不大了。
六、口碑:用的人多,和用的人满意,是两回事
Stack Overflow 2025 年的开发者调查里,用 OpenAI GPT 系列的有 81%,用 Claude Sonnet 系列的有 43%。但同一份调查里,46% 的开发者不信任 AI 输出的准确性,比前一年的 31% 还高。
用得越多,越不放心。 这和我"AI 说已完成,你就信了?"那篇的体会是一回事。
满意度又是另一幅图。YouGov 在英国的调查里,Claude 的净满意度是 56.2,ChatGPT 是 46.0;只看当前用户,DeepSeek 最高,77.2。但美国 ACSI 的调查里,Claude 和 ChatGPT 都是 73 分,Gemini 反而最高。
所以,"Claude 在某项满意度调查里领先"有依据;"大家都觉得 Claude 更好",没有。至于 Kimi、GLM 的口碑,我没找到能和这些调查放在一起比的数据,就不硬排了。
七、我的记账法
宣传页上的数字,比不过一周的真实记录。我的建议很朴素:拿一周的真实活,每件事记五样东西。
| 记什么 | 为什么 |
|---|---|
| 任务是什么 | 一次只记一件能验收的事 |
| 有没有通过验收 | 按我在"已完成"那篇里说的四层来判 |
| 额度掉了多少 | 开工前后各截一张图 |
| 花了多少时间 | 包括你等它和你检查它的时间 |
| 返工了几轮 | 原地打转是额度黑洞 |
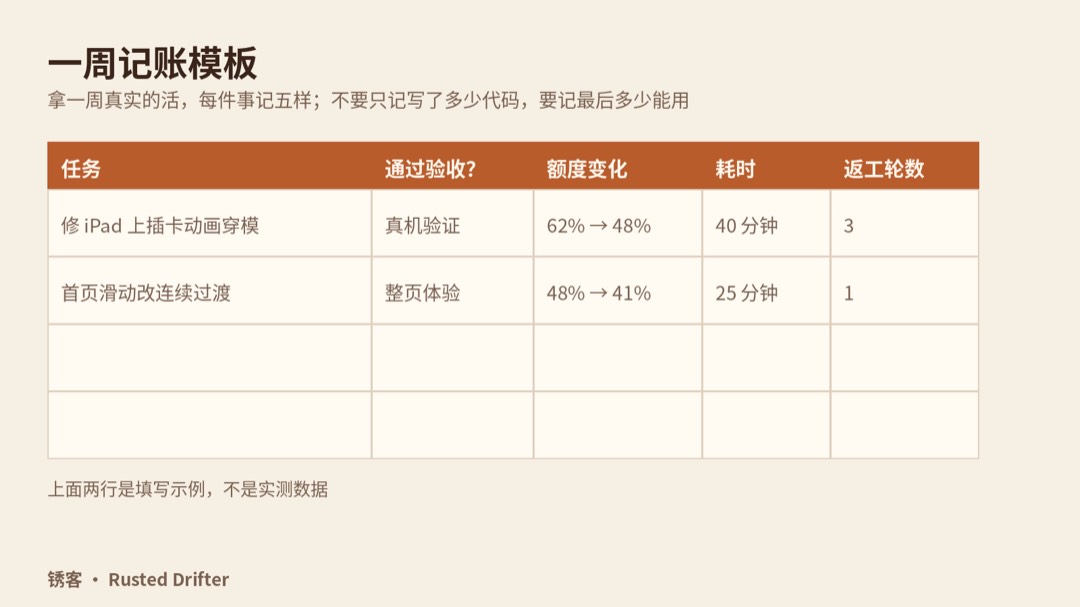
不要只记"它写了多少代码",要记"最后有多少能用"。
写在最后
做产品的人都知道,用户买的从来不是参数,是体验。AI 会员也一样,最后要落在三个问题上:
它能不能完成你的活?你要为它收拾多少残局?你最需要它的时候,它还有没有额度?
这三件事,比宣传页上的 token 数更接近你真正买到的东西。
入门篇到这里讲完了。下一篇开始实战:我用五天、约千 M Token,口搓了一台掌机模拟器。
锈客 · Rusted Drifter
做了十年手机产品的产品狗,手艺生了锈,在异乡用 AI 重新上手。写行业判断、Agent 与 Vibe Coding 实录,和一个老产品人的回炉笔记。
你的额度一般多久用完?用的是哪家?留言晒晒账单。
参考资料(核对日期 2026-10-29;价格和额度变化快,以官方页面为准)
- Anthropic 帮助中心:Pro 套餐用量说明,以及在 Pro / Max 套餐中使用 Claude Code
- OpenAI:Codex 定价页;Codex 5 小时限额的取消与恢复(eesel.ai 2026-07、9to5Mac 2026-08-24,引用 Codex 负责人在 X 上的发言)
- Anthropic 用量限制的演变:周上限公告(The Decoder,2025-07-28)、高峰时段调整(2026-03)、Claude Ultra 取消 5 小时限额(Anthropic 官方 X 账号,2026-10-30,DataStudios 等报道)
- Kimi、Z.ai(GLM Coding Plan)的官方会员与套餐说明(Kimi 截图日期 2026-10-19)
- Bai 等:How Do AI Agents Spend Your Money?(arXiv,2026),关于 Agent 编程任务 Token 消耗的研究
- 模型能力榜单:Revelo Code Index,Vals SWE-bench Verified(BenchLM 2026-09-01 快照)
- 用户调研:Stack Overflow 2025 开发者调查,YouGov 2026 英国 AI 品牌满意度排名,ACSI 2026 AI 平台满意度研究(据 SlashGear 报道)
锈了,还在路上。